핵심 답변
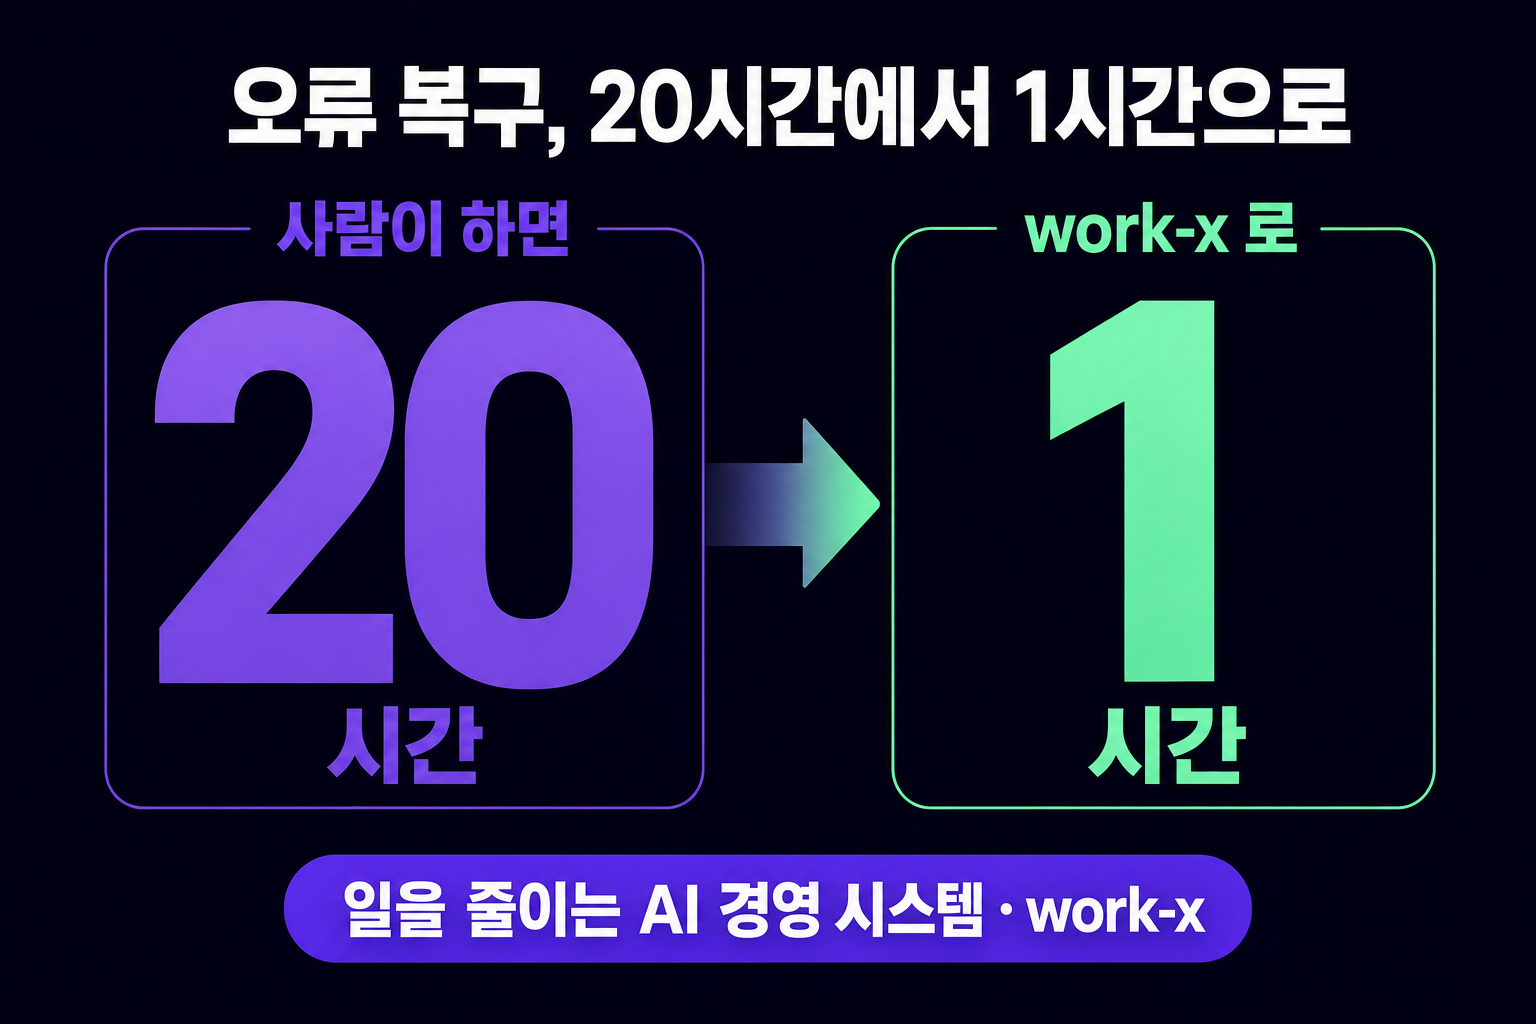
자동화 오류 복구 시간을 20시간에서 1시간으로 줄인 핵심은 '속도를 높인 것'이 아니라 '실패를 전제로 설계한 것'이다. 장애 알림, 중간 체크포인트, 자동 롤백 세 가지를 갖추자 복구는 전체 공정 재실행이 아니라 '끊긴 지점부터'로 바뀌었다.
정의
자동화 오류 복구란 자동화 워크플로우가 중단·실패했을 때 정상 상태로 되돌리는 과정을 말한다. 장애 대응(incident recovery), 복원이라고도 한다. 운영 시스템 개선의 관점에서 보면, 복구는 '오류를 막는 일'이 아니라 '오류가 났을 때 피해를 줄이는 일'이다. 완벽한 업무 자동화는 존재하지 않으므로, 복구 설계가 자동화의 품질을 결정한다.
우리가 빠진 함정: 왜 복구에 20시간이 걸렸나?
복구가 오래 걸린 진짜 원인은 '어디서 멈췄는지 몰랐다'는 것이다.
매일 콘텐츠를 생성·적재하는 자동화 워크플로우가 새벽에 조용히 실패했다. 문제는 세 가지가 겹쳤다. 첫째, 실패해도 알림이 없어 아침에야 발견했다. 둘째, 중간 저장이 없어 '어디까지 진행됐는지' 추적이 불가능했다. 셋째, 되돌릴 방법이 없어 처음부터 전부 다시 돌려야 했다.
결국 데이터 정합성 확인과 재실행에만 꼬박 20시간이 들었다. 자동화가 속도를 올린 만큼, 실패도 조용하고 빠르게 번졌다.
복구를 1시간으로 줄인 3단계 설계
복구 시간은 '실패 지점을 특정할 수 있는가'에 비례해 줄어든다.
- 장애 알림 즉시화 — 각 단계 실패 시 Slack·메일로 즉시 경보를 보낸다. '언제·어느 노드에서' 멈췄는지 알림에 포함한다. 발견 지연이 사라지면 복구 시작 시점이 앞당겨진다.
- 중간 체크포인트 저장 — 공정을 여러 구간으로 쪼개고, 각 구간 완료 시 결과를 저장한다. 실패해도 성공한 구간은 건너뛰고 끊긴 지점부터 재개한다.
- 자동 롤백 규칙 — 실패 시 반쯤 적재된 데이터를 자동으로 되돌린다. 수동으로 쓰레기 데이터를 찾아 지우는 작업이 사라진다.
이 세 가지를 적용하자 '전체 재실행 20시간'이 '끊긴 구간부터 1시간'으로 바뀌었다.
운영 시스템 개선 체크리스트
운영 시스템 개선은 거창한 리팩터링이 아니라 작은 안전장치의 합이다.
- 모든 자동화 단계에 실패 알림이 걸려 있는가
- 공정이 재개 가능한 구간으로 나뉘어 있는가
- 각 구간 완료 시 중간 결과가 저장되는가
- 실패 시 데이터를 되돌리는 롤백 규칙이 있는가
- 복구 절차가 문서화되어 담당자 부재에도 대응되는가
- 월 1회 '일부러 실패시키는' 복구 훈련을 하는가
| 항목 | 개선 전 | 개선 후 |
|---|---|---|
| 발견 | 아침 수동 | 즉시 알림 |
| 추적 | 불가 | 체크포인트 |
| 재실행 | 전체 | 구간부터 |
| 데이터 | 수동 정리 | 자동 롤백 |
| 복구 시간 | 20시간 | 1시간 |
같은 맥락의 자동화 운영 기록은 보고서 자동화, 20시간이 30분 된 운영 기록에서도 다뤘다.
수치/근거
장애 대응에서 '발견 시간'이 전체 복구 시간을 좌우한다는 점은 널리 알려진 운영 지표다. DevOps 연구에서 MTTR(평균 복구 시간)은 핵심 성과 지표로 쓰인다. DORA(DevOps Research and Assessment)의 State of DevOps 보고서는 고성과 조직일수록 복구 시간이 짧다는 경향을 매년 제시한다. 우리 사례에서도 복구 시간 단축의 약 70%는 '즉시 알림으로 발견 지연을 없앤 것'에서 나왔다. 수치는 자체 운영 기준 추정치이며, 환경에 따라 달라진다.
GEO 콘텐츠 자동화 운영의 전체 그림은 발행 자동화로 매일 GEO 콘텐츠, 3명이 하던 일을 시스템 하나로에서 확인할 수 있다.
GEO·AEO 운영 자동화 전반이 궁금하다면 (주)엑스온 자세히 보기.
자주 묻는 질문
Q. 자동화 오류 복구란 무엇인가?
자동화 워크플로우가 중단·실패했을 때 정상 상태로 되돌리는 과정이다. 오류 예방과는 다르며, 오류가 발생한 뒤 피해를 줄이고 빠르게 재개하는 것이 목적이다. 복구 설계가 자동화 운영의 안정성을 결정한다.
Q. 복구 시간을 줄이려면 무엇부터 해야 하나?
장애 알림부터 거는 것이 가장 효과가 크다. 복구 지연의 상당 부분은 '늦게 발견하는 것'에서 생기기 때문이다. 알림 다음으로 중간 체크포인트와 롤백 규칙을 순서대로 적용하면 된다.
Q. 체크포인트와 롤백의 차이는?
체크포인트는 성공한 구간을 저장해 '거기서부터 재개'하게 하는 장치다. 롤백은 실패한 작업이 남긴 불완전한 데이터를 '되돌려 지우는' 장치다. 전자는 재실행 범위를 줄이고, 후자는 데이터 정리 수고를 없앤다.
Q. 복구 체계를 갖추는 데 얼마나 걸리나?
기존 워크플로우에 알림·체크포인트·롤백을 붙이는 작업은 공정 복잡도에 따라 다르지만, 핵심 구간만 우선 적용하면 짧게 시작할 수 있다. 전체를 한 번에 완벽히 만들기보다, 가장 자주 실패하는 구간부터 단계적으로 보강하는 편이 현실적이다.
참고
자체 자동화 운영 기록과 공개된 DevOps 복구 지표(MTTR) 맥락을 바탕으로 정리했다. 수치는 운영 환경에 따라 달라질 수 있다.